Qwen3.8 27B
18 GB
Reasoning, coding, research, агенты, анализ изображений и видео.
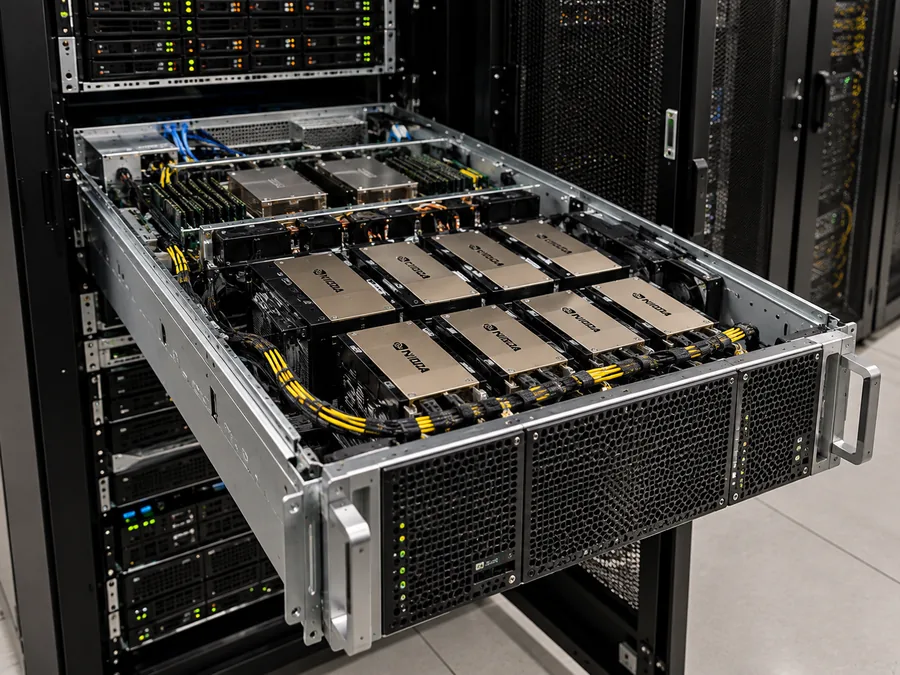
Выделенная NVIDIA Tesla V100 32 GB с размещением в РФ для LLM, RAG, Speech‑to‑Text, эмбеддингов, computer vision.
12 900 ₽ / 7 дней и 38 600 ₽ / 30 дней — за 1 V100
2× V100 дают суммарно 64 GB VRAM для приложений, поддерживающих multi-GPU/model sharding. NVLink ускоряет обмен данными между GPU.
Tesla V100 построена на архитектуре Volta GV100 — поколении, в котором NVIDIA впервые добавила Tensor Cores. 32 GB HBM2 с ECC и пропускной способностью до 900 GB/s дают запас памяти для LLM, KV‑cache, batch, изображений и CUDA‑буферов.
Видеопамять расходуется на контекст, KV‑cache, активации и рабочие данные. 32 GB позволяют запускать крупные квантизованные модели и собирать несколько AI‑сервисов на одной машине.
PyTorch, CUDA, computer vision, scientific computing и собственный GPU‑код.
Tensor Cores ускоряют матричные операции для обучения и inference нейросетей.
На V100 можно запускать множество разных моделей, у которых вес менее 32 GB, вот некоторые из них:
Reasoning, coding, research, агенты, анализ изображений и видео.
Мультимодальная модель Google для reasoning, coding, agentic‑задач и изображений.
Reasoning‑модель для математики, логики, анализа и программирования.
Генерация и анализ кода, исправление ошибок и developer‑ассистенты.
MoE‑модель: 24B параметров, около 2B активных параметров на токен.
Специализированный перевод на базе Gemma 3 с поддержкой 55 языков.
Vision, function calling, ассистенты и длинный контекст.
Embedding‑модель для dense, sparse и multi‑vector retrieval, более 100 языков.
В каталоге Ollama — больше тысячи открытых моделей с весами до 32 GB под разные задачи.
Объедините несколько V100 — суммарный объём VRAM нескольких GPU доступен workloads, поддерживающим распределение модели между картами.
Qwen3.8 27B, Gemma 4 31B, DeepSeek‑R1 32B и другие крупные квантизованные модели, которые помещаются в 32 GB VRAM.
Ollama · llama.cppLLM + embeddings + векторная БД: поиск по базе знаний, ответы по документам, классификация и суммаризация.
Qwen3.8 · BGE‑M3Whisper и faster‑whisper для транскрибации звонков, встреч, интервью, видео и аудиоархивов на CUDA.
Whisper · faster‑whisperBGE‑M3 для retrieval, векторных баз, поиска похожих документов и многоязычных RAG‑систем.
BGE‑M3 · Vector DBStable Diffusion, ComfyUI и другие CUDA‑пайплайны, которым важен большой объём VRAM.
ComfyUI · DiffusersYOLO, OCR, сегментация, классификация, LoRA, PyTorch и собственные CUDA‑задачи.
PyTorch · CUDA · OpenCVДля сравнения — текущие публичные цены российских сервисов на конфигурации с одной NVIDIA V100. Так же есть тариф — 12 900 ₽ за 7 дней.
Мы на GPUИндекс и в категории Nvidia V100 32 GB
24 часа с момента выдачи SSH.
Неиспользованный тест не переносится.
Запрещены майнинг, спам, сканирование, прокси и другие злоупотребления.


После регистрации протестируйте V100 бесплатно.
Да. Доступ на 24 часа выдаётся бесплатно для проверки вашей нагрузки. Если сервер подходит — аренда продолжается за 38 600 ₽ на 30 дней или 12 900 ₽ на 7 дней.
Да, если они вместе помещаются в VRAM с учётом runtime и KV‑cache. Например, веса Qwen3.8 27B и BGE‑M3 в Ollama занимают примерно 18 GB и 1.2 GB — практичная связка для RAG на одной V100 32 GB.
Да. На CUDA можно запускать Whisper и faster‑whisper. Скорость на ваших аудиофайлах можно проверить за бесплатные 24 часа.
Да. Во время теста можно проверить GPU и доступную память через nvidia-smi и запустить собственный workload.
Базовая конфигурация: 11 vCPU, 28 GB RAM, 90 GB SSD, порт 1 Gbit/s. Перед выдачей теста подтверждаем параметры конкретного сервера.
Доступна физическим лицам, ИП и юридическим лицам. Для ИП и юрлиц — договор и оплата в рублях. Стоимость указана без НДС.
Запустите свою модель или пайплайн на V100 32 GB. Если всё подходит — оставляете сервер на 30 дней за 38 600 ₽ или на 7 дней за 12 900 ₽.
Получить V100 на 24 часа